Les PME perdent des heures chaque semaine dans le courrier entrant. Pas à y répondre : à décider ce que c'est. Un fournisseur qui confirme une date, une facture, une vraie demande de mandat, et quarante messages de bruit dans la même enveloppe.
Voici le journal de bord d'un agent qui prend cette décision, sur du matériel qui coûte moins qu'un mois de budget IA typique. L'intérêt de l'écrire n'est pas la machine. C'est que l'écart entre une démo et un outil qu'on peut laisser tourner est fait de décisions d'ingénierie — et c'est cela qu'une PME achète réellement.
Le projet
L'agent s'appelle apigmail. Il lit le courrier entrant et produit, pour chaque message, trois choses : de quel type de message il s'agit, ce qui doit lui arriver et son degré d'urgence. Ce qui exige un humain reçoit un court résumé et une prochaine action proposée. Le reste est classé, archivé ou jeté sans que personne le regarde.
Il tourne sur un Mac mini posé sur une tablette — 1 199 $ CAD, seize gigaoctets de mémoire unifiée, acheté une seule fois. Aucune location de GPU, aucune facture au jeton, et aucun courriel qui sort de l'entreprise, ce dernier point étant le premier que soulèvent les clients réglementés.
La cible
Avant de construire quoi que ce soit, il fallait écrire la tâche sous une forme qui puisse réussir ou échouer. On n'ingénie rien contre des ambitions vagues ; contre celles-ci, oui :
- Ne jamais jeter un message légitime. Un courriel de client perdu est pire que pas d'automatisation du tout, parce qu'à ce stade on fait confiance à la boîte.
- Ne jamais rater un message qui exige une réponse. Le rappel sur cette classe compte plus que l'exactitude globale.
- Décider sans intervention humaine dans les cas clairs, et escalader le reste plutôt que deviner.
- Terminer son travail durant la nuit sur du matériel déjà possédé, sans qu'aucune donnée ne quitte le réseau.
Puis la mesure : deux cents courriels d'affaires synthétiques, écrits et étiquetés à la main, chaque expéditeur et chaque domaine inventés pour que le jeu de test ne contienne le vrai courrier de personne — avec une trentaine de cas volontairement difficiles : des réponses sans conversation derrière, des messages en français, en espagnol et en allemand, des démarchages déguisés en mots personnels. Chaque version depuis est notée sur ce même jeu par macro-F1 par axe, parce que les classes sont déséquilibrées et qu'une simple exactitude flatterait le résultat. Et une livraison doit franchir un seuil fixe avant d'être mise en service : au plus 0,5 % de JSON invalide, au plus 0,5 % de courrier légitime jeté, au moins 0,90 de rappel et 0,85 de précision sur le courrier qui exige une réponse, au moins 0,75 de rappel sur les indésirables. Ce jeu de test s'est révélé l'artefact le plus précieux du projet.
Corriger la mesure avant le modèle


Cela mérite un paragraphe parce que c'est l'échec le plus courant dans ce type de travail. Une semaine d'ajustements contre une métrique cassée produit des absurdités mesurables et assurées. Avant d'optimiser quoi que ce soit, vérifiez que le chiffre décrit bien ce que vous croyez qu'il décrit.
À quoi la démarche a réellement ressemblé
Trois versions de modèle et huit versions de prompt, toutes notées sur le même jeu de test. Quatre constats méritent d'être transmis.
Un modèle plus gros n'a rien apporté. La première version demandait à un modèle 8B la catégorie, le verdict et la priorité en une passe : excellent pour repérer qu'un humain avait écrit, nul devant les indésirables — deux sur vingt-cinq détectés, vingt marqués comme exigeant une réponse. Passer à un modèle 14B n'a rien changé au schéma de confusion et a légèrement fait baisser le score de verdict, de 0,473 à 0,435, pour deux secondes et demie de plus par message.
Écrire les règles a rapporté plus que le matériel. Même modèle, même machine : énoncer explicitement les règles de décision — ce qui sépare un message à archiver d'un message à laisser tranquille, ce qui rend une chose indésirable, à quoi ressemble une infolettre qui se fait passer pour un mot personnel — a fait passer le score de verdict de 0,435 à 0,692.
Le verdict n'a pas sa place dans le modèle. Le changement le plus important a été structurel. Le modèle n'extrait plus que des faits observables : qui écrit, y a-t-il une demande, y a-t-il une offre, quelqu'un réclame-t-il un paiement ou un identifiant. Du code déterministe combine ces faits avec un contexte que le modèle ne peut pas connaître — correspondance antérieure avec cet expéditeur, avons-nous répondu, présence au carnet d'adresses, domaines qui ne font que ressembler à une marque connue — et c'est ce code qui produit le verdict. Le rappel sur les indésirables est passé de 0,24 à 0,76 sans qu'un seul message légitime soit jeté. Le prix était honnête : la latence a augmenté d'environ deux tiers, de 12,6 à 20,6 secondes par message.
Deux livraisons ont été rejetées, et c'est précisément à ça que sert le seuil. Un prompt reformulé n'a gagné aucune précision et perdu trois points de rappel sur les messages à répondre. Une version 9B plus rapide en quantification quatre bits affichait les meilleurs scores de catégorie du projet et a tout de même échoué : le rappel sur les indésirables tombait à 0,60 et elle a jeté un courriel légitime. Il a fallu deux versions de prompt de plus — marques imitées dans des domaines composés, fausses chaînes de réponses, respect du courrier déjà lu, conversations en cours laissées tranquilles — avant que ce modèle soit sûr.
Les résultats
| Essai | Version | F1 verdict | À répondre P / R | Indésirable P / R | Issue |
|---|---|---|---|---|---|
| 01 | hermes3:8b · v1 | 0.473 | 0.71 / 1.00 | 1.00 / 0.08 | référence |
| 02 | qwen3:14b · v2 | 0.435 | 0.76 / 0.97 | 1.00 / 0.16 | modèle plus gros, aucun gain |
| 03 | qwen3:14b · v3 | 0.692 | 0.78 / 0.94 | 1.00 / 0.24 | règles explicites |
| 04 | qwen3:14b · v4 | 0.835 | 0.88 / 0.96 | 1.00 / 0.76 | le code décide du verdict |
| 05 | qwen3:14b · v5 | 0.838 | 0.96 / 0.90 | 1.00 / 0.72 | rejetée — rappel perdu |
| 06 | qwen3.5:9b · v6 | 0.824 | 0.94 / 0.95 | 0.94 / 0.60 | échec — un vrai courriel jeté |
| 07 | qwen3.5:9b · v7 | 0.874 | 0.96 / 0.95 | 1.00 / 0.77 | acceptée |
| 08 | qwen3.5:9b · v8 | 0.868 | 0.97 / 0.96 | 1.00 / 0.77 | actuelle |
La version actuelle fait tourner un modèle 9B en quantification quatre bits, réflexion désactivée, fenêtre de contexte de 8k. Sur le jeu de test, elle atteint 0,97 de précision et 0,96 de rappel sur le courrier qui exige une réponse, une précision parfaite sur les indésirables, et aucun message légitime jeté. Sur la boîte réelle, elle tourne sous les dix-neuf secondes par message et envoie au modèle environ un quart de texte en moins que la première version fonctionnelle.
La capacité, puisqu'elle détermine si tout cela tient à l'échelle d'une entreprise. Le mini répond à une requête à la fois : le plafond est donc une simple division. 86 400 secondes dans une journée divisées par environ 19 secondes par message donnent quelque 4 500 messages par jour. Le goulot d'étranglement, c'est le modèle — ni le disque, ni le réseau, ni le fournisseur de courriel. Une entreprise qui reçoit quelques centaines de messages par jour n'utilise qu'une petite fraction d'un seul ordinateur de bureau, et la marge est là pour les jours où tout le monde écrit en même temps.
Et ce plafond n'est que le plancher de ce qu'un budget permet. Le travail se fait un message à la fois, ce qui le rend parallélisable sans effort : une deuxième machine à 1 199 $ double le plafond, sans rien changer à la conception. Plutôt que d'ajouter des boîtiers, un budget plus large achète un modèle plus gros ou une fenêtre de contexte plus longue sur une seule machine — et un modèle hébergé reste la bonne réponse pour tout ce qu'une personne attend en direct. L'intérêt de commencer ici n'est pas que ce soit la limite : c'est que le matériel le moins cher possible traite déjà plusieurs fois le courrier d'une PME, ce qui permet de mettre l'argent là où il faut du jugement.
En test de productionLa prochaine amélioration mène la même machine plus loin. Un courriel en environ neuf secondes au lieu de dix-neuf, et un plafond d'environ 9 500 courriels par jour sur un flux, 16 000 sur deux — sur la même machine à 1 199 $, sans rien acheter.
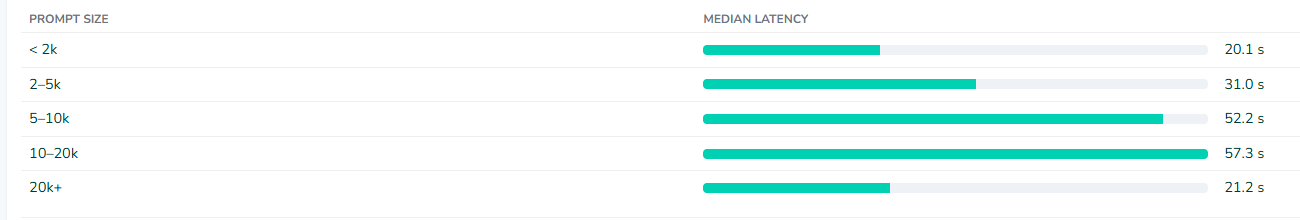
Le compromis. Plus court, c'est plus rapide : rien au-delà de 8 000 caractères n'est lu — le modèle reçoit les 6 000 premiers et les 2 000 derniers, et le milieu d'un très long courriel est ignoré. C'est pourquoi 20k+ revient plus vite que 10–20k.
Une réserve, dite clairement : toutes les confirmations humaines recueillies jusqu'ici portent sur la version 14B retirée.
Ce que ça signifie pour une PME
Le matériel n'a jamais été le plus difficile, le modèle non plus. Chaque gain significatif est venu d'une décision d'ingénierie : mesurer correctement, écrire les règles, sortir le jugement du modèle pour le mettre dans du code testable, et maintenir un seuil autorisé à rejeter votre propre travail.
C'est exactement ce que procurent deux décennies à construire des systèmes, et c'est pourquoi une petite entreprise n'a pas besoin d'un budget IA pour obtenir un outil qui se rentabilise. Un ordinateur de bureau bon marché, un modèle à poids ouverts et quelqu'un qui l'a déjà fait : une combinaison à la portée de la plupart des PME — et elle donne un outil qui tourne chaque nuit, ne coûte rien par message et garde votre correspondance chez vous.
Si une décision récurrente de votre entreprise ressemble à celle-ci — gros volume, règles claires, coûteuse seulement parce qu'une personne doit la prendre — cela vaut une demi-heure pour savoir ce qu'il faudrait.